Telegram数据量一旦上来,真正决定效果的就不再是获取渠道,而是过滤能力。同样是5万条数据,有的团队能筛出高密度用户,有的却被无效号码拖垮,核心差距就在于有没有把无效数据提前清掉。
这一篇直接按实操流程来讲,从一批原始数据开始,一步一步拆到最终可用数据,重点是每一步具体怎么做。
原始5万数据的真实结构拆解
先看一批典型Telegram号码在未处理前的组成。很多人以为数据是干净的,其实不是,通常会混合:
- 空号或不存在号码
- 未注册Telegram账号
- 已注册但长期不使用
- 正常活跃用户
- 重复数据
这些数据如果直接使用,相当于把有效用户和无效用户混在一起,结果就是整体表现被拉低。
第一轮:未筛选直接使用的结果
某项目在东南亚市场导入约5万条Telegram号码,未做任何筛选直接触达。
结果表现:
- 实际可触达用户比例偏低
- 回复率集中在极少部分用户
- 大部分发送无反馈
- 不同批次结果波动明显
这一步的核心问题不是发送,而是数据本身质量不一致。
无效号码过滤的完整方法
要解决问题,必须把过滤流程拆清楚,而不是简单检测一遍。
完整方法可以分为四步:
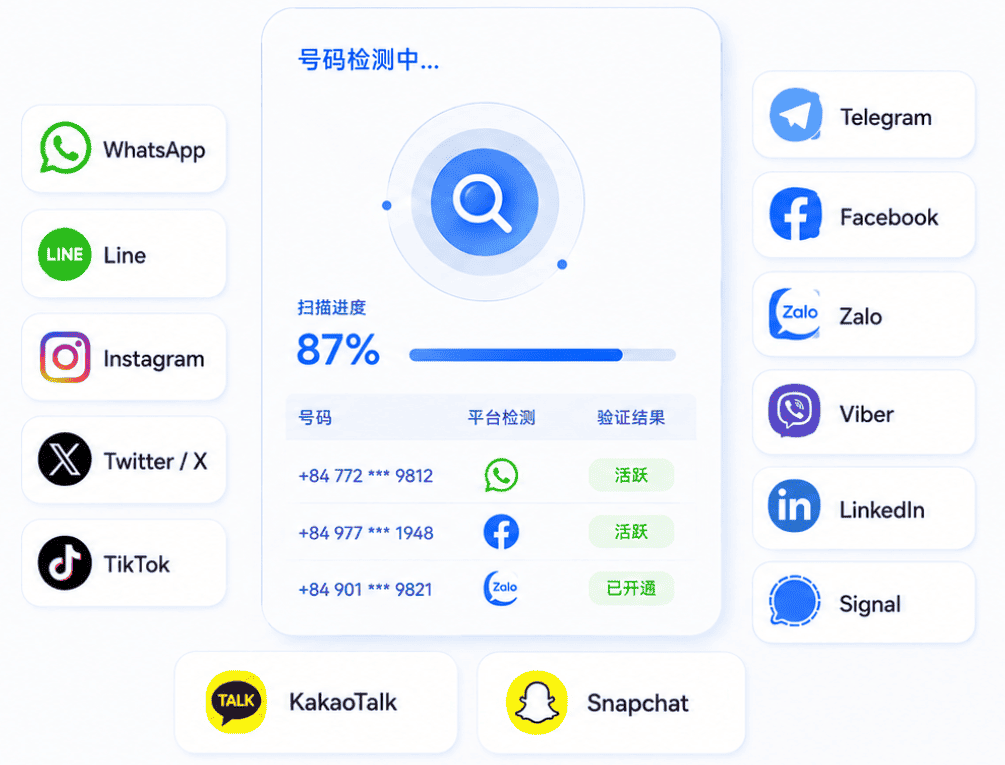
- 空号检测
过滤掉不存在的号码,这是最基础的一层
- 注册检测
判断是否开通Telegram账号
- 活跃筛选
筛出近期有行为的用户
- 异常账号过滤
去掉不稳定或风险账号
通过abcheck,可以把这四步合并为一次批量处理,直接输出结果。
第二轮:过滤后的数据变化
经过完整筛选后,原始5万数据通常会被压缩:
- 剩余约2万左右
- 空号和未注册数据基本清掉
- 数据集中在可用用户
再进行触达:
- 回复明显集中
- 有效触达比例提升
- 数据稳定性明显改善
数据变少,但价值明显提高。
为什么过滤比扩量更重要
很多团队的第一反应是继续加数据,但问题不在数量,而在结构。
无效数据越多:
- 有效用户被稀释
- 发送成本增加
- 转化被拉低
过滤的本质是提升用户密度,而不是减少数据。
数据密度提升带来的变化
当无效号码被过滤之后,会出现几个明显变化:
- 高活跃用户占比上升
- 回复更集中
- 每一批数据表现更稳定
这也是为什么筛选后的数据更容易优化,而不是反复试错。
如何长期保持数据质量
很多人只做一次过滤,这会导致后期效果下降。
正确做法是:
- 新数据每批都先筛选
- 老数据定期复筛
- 避免重复使用旧数据
通过abcheck,可以实现批量复筛,让数据持续保持可用状态。
案例:筛选流程优化后的提升
某欧洲项目在优化筛选流程前后,对比非常明显:
优化前:
- 数据量大但无效多
- 回复率波动
- 无法稳定复用
优化后:
- 数据减少约50%
- 回复率稳定提升
- 用户集中度明显提高
关键变化不是渠道,而是过滤流程。
用abcheck做过滤的优势
在实际操作中,abcheck的价值主要体现在前端处理:
- 批量空号检测
- 注册状态识别
- 活跃用户筛选
- 异常数据过滤
同时支持API,可以把筛选直接接入系统流程,实现自动化。
一个更实际的操作逻辑
Telegram数据处理可以简化为一句话:
先过滤,再使用
而不是:
先发送,再筛选
当顺序正确之后,整个数据链路会明显顺畅。
结论:无效数据决定上限
在Telegram场景中,无效号码不是小问题,而是决定整体上限的关键因素。
同样是5万数据:
未筛选 → 看起来多,但无效
筛选后 → 数量少,但能转化
真正拉开差距的,不是数据来源,而是过滤能力。