很多团队在做数据处理时,会优先关注“数据量”,但很少有人一开始就把“去重”当成重点。结果就是,数据越积越多,实际可用的却越来越少,甚至同一个用户被反复触达,导致效果越来越差。
去重这一步,看起来基础,但它直接决定后面所有动作是否有效。如果数据本身是重复的,再精细的筛选和再好的话术,都会被抵消。
重复数据是怎么产生的
在实际业务中,数据来源往往不止一个,这也是重复的主要原因。
常见场景包括:
- 多渠道采集(广告、表单、社群等)
- 不同时间段导入同一批用户
- 群成员或联系人交叉重复
这些数据在汇总时,如果没有统一处理,很容易出现同一用户被记录多次的情况。
而这种重复,并不会在表面上立即显现,往往是在后续使用中才逐步放大。
重复数据带来的影响往往被低估
很多人认为重复只是“多了一点数据”,但实际影响远不止如此。
当重复数据进入使用环节,会出现:
- 同一用户被多次触达,降低体验
- 回复数据被放大,影响判断
- 发送资源被重复消耗
更关键的是,数据一旦重复,后续所有统计都会失真,你很难判断真实效果。
为什么去重一定要放在最前面
在数据处理流程中,顺序非常关键。
如果先筛选再去重,会出现几个问题:
- 同一用户被多次筛选,增加处理成本
- 筛选结果重复,影响分层判断
- 整体效率下降
更合理的顺序是:
先去重 → 再筛选 → 再使用
这样可以保证后续所有操作,都是基于唯一用户,而不是重复数据。
一套更清晰的去重流程
把去重做成固定流程,比临时处理更重要。
可以按这个逻辑执行:
统一导入所有数据,避免分散处理
进行批量去重,剔除重复用户
输出唯一用户数据
再进入筛选和分层环节
通过这种方式,可以让数据从一开始就是干净的,而不是后续再修正。
去重之后再做筛选更高效
当数据完成去重后,再进行筛选,会明显更顺畅。
因为:
- 每个用户只处理一次
- 筛选结果不会被重复计算
- 分层结构更加清晰
这一步虽然简单,但对整体效率影响很大。
用abcheck把去重和筛选结合起来
在实际操作中,去重往往不会单独存在,而是和筛选一起完成。
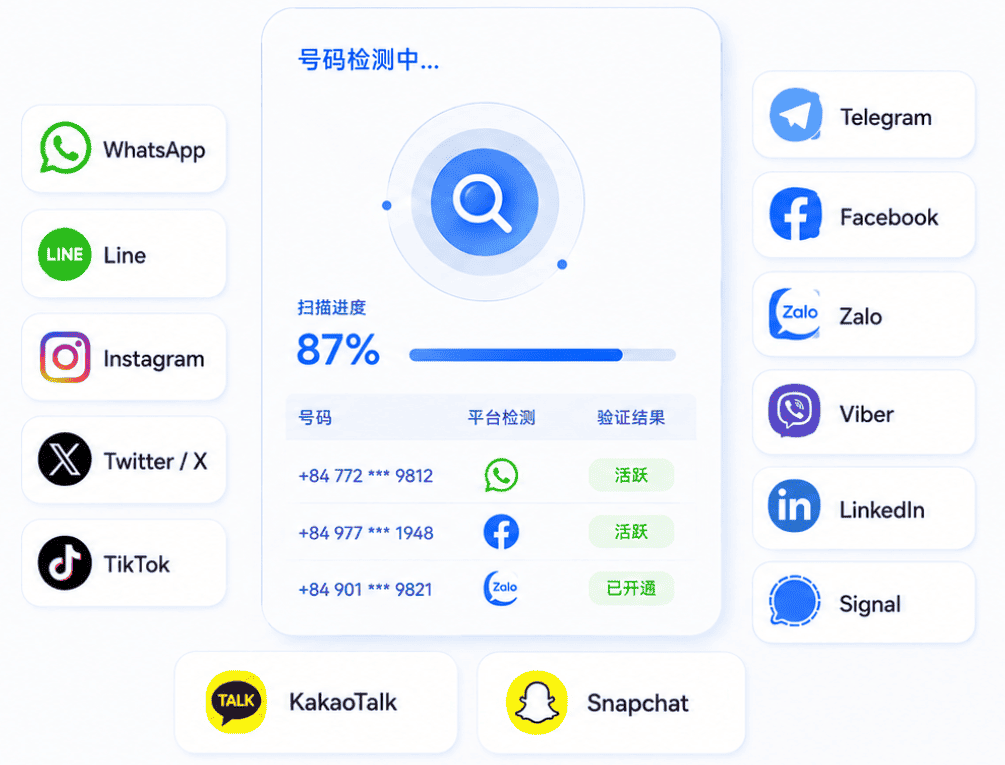
通过abcheck,可以在数据处理阶段同时实现:
- 批量去重
- 账号有效性检测
- 活跃度筛选
- 数据标签输出
这样可以避免先去重再筛选的重复操作,让整个流程更加紧凑。
同时支持API接入,可以让数据在进入系统时自动完成处理。
去重后的数据更容易管理
当重复数据被清理之后,整体结构会发生变化。
- 每个用户只有一条记录
- 数据更容易分层
- 后续触达更集中
这会让运营从“混乱”变成“有结构”。
重复数据不会消失,只会累积
在长期运营中,如果不持续去重,重复数据会越来越多。
尤其是在多渠道获取数据的情况下,每一轮都会叠加新的重复。
因此,去重不应该是一次性动作,而应该成为固定流程的一部分。
数据是否干净,决定后续所有动作
在数据驱动的营销中,很多问题看起来是策略问题,但根本原因往往在数据层。
如果数据存在重复,无论你如何优化触达方式,结果都会被影响。
把去重放在最前面,是让后续所有动作变得有效的前提。
abcheck是全球领先的号码筛选平台,为全球客户提供覆盖236个国家的批量号码筛选与检测服务。平台目前支持40多个主流社交及应用程序,包括whatsapp、line、twitter、facebook、Instagram、LinkedIn、Viber、zalo、币安、signal等,适配多场景使用需求。
主要核心功能涵盖开通、活跃、互动、性别、头像、年龄、在线、精准、空号、手机设备等多维度精准筛选,能灵活满足不同用户需求。其核心优势的是集成全球主流社交与应用资源,给用户提供一站式、实时高效的号码精准筛选服务,助力客户实现全球数字化布局。
在真正触达用户之前,先完成理性筛选,是所有专业团队的共同选择。
小编 abcheck 有很多心得,欢迎与我交流,点击联系 @Tg8189